Paso 01 — Sube un retrato
Sube una foto de retrato nítida — esta es la cara que Omnihuman cobra vida. Una toma frontal nítida y bien iluminada ofrece el resultado más natural.
Cleep AI pone a tu alcance un modelo de Human Video Generation basado en un Multimodal AI Framework: combina imagen, rostro y guía de movimiento para crear clips coherentes, con identidad estable y estilo controlado.
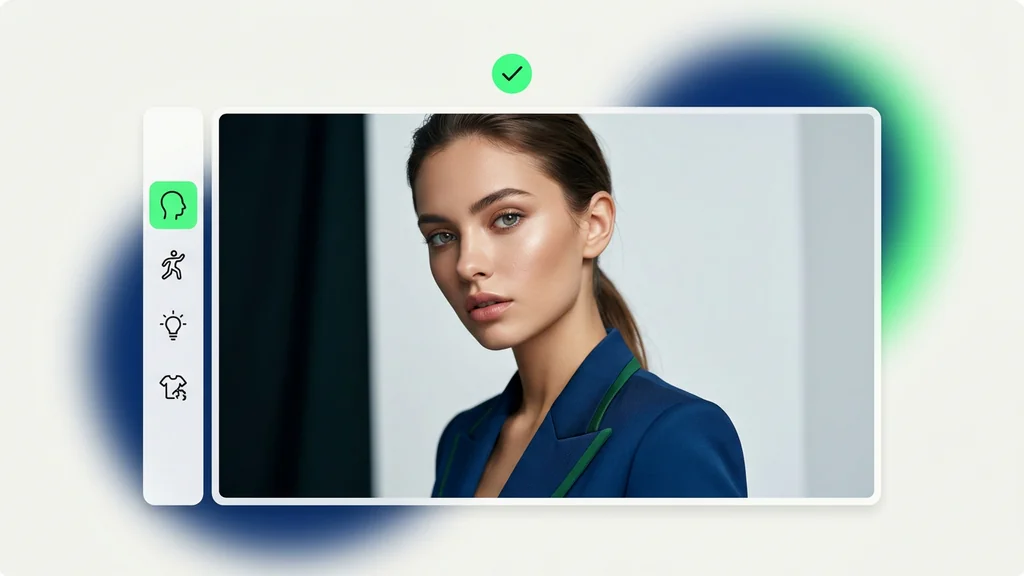
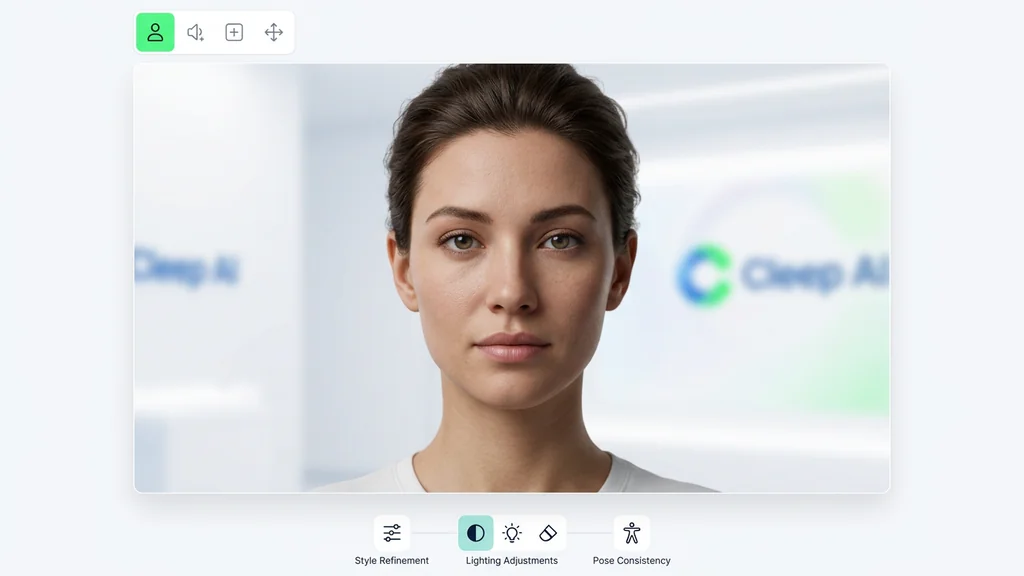
De una foto o clip y una pista de audio a un vídeo que habla con realismo — directamente en Cleep.ai.
Sube una foto de retrato nítida — esta es la cara que Omnihuman cobra vida. Una toma frontal nítida y bien iluminada ofrece el resultado más natural.
Sube la pista de voz o música (hasta 30s). Omnihuman sincroniza el movimiento de los labios y la expresión con tu audio para una interpretación natural.
Haz clic en generar y espera unos minutos. Omnihuman produce tu vídeo que habla con audio sincronizado. Descárgalo y compártelo, o cambia los archivos para una nueva versión.
Primero se aporta una referencia (por ejemplo, un vídeo de movimiento) y una imagen de identidad para fijar el rostro. Después se ajustan parámetros clave como duración, encuadre y nivel de fidelidad, y se lanza la generación. El resultado se revisa y se itera con nuevas referencias o ajustes hasta encajar con el guion y el estilo de marca.
La herramienta se usa para vídeos de producto con presentadores virtuales, piezas de performance para anuncios y módulos de formación interna con un avatar consistente. También encaja en localización de contenidos cuando se necesita mantener la identidad y adaptar el mensaje a distintos mercados. En entornos creativos, permite prototipar escenas con humanos sin montar rodajes completos.
Para validar resultados, se revisan estabilidad de identidad, sincronía labial (si aplica), continuidad de manos y artefactos en bordes y cabello. El enfoque multimodal ayuda a mantener coherencia cuando cambian las entradas, pero conviene iterar con referencias más limpias para escenas complejas. En Cleep AI se recomienda trabajar con material propio o con permisos para evitar usos indebidos de identidad.
Cleep AI centraliza el acceso al modelo y lo convierte en un flujo operativo: entradas claras, generación repetible y salida lista para equipos. La base técnica se alinea con un multimodality-conditioned framework descrito en el paper arxiv.org/abs/2502.01061, útil para entender el enfoque de control por múltiples modalidades. Esto facilita evaluar el encaje en pipeline de contenido, desde prototipos hasta entregables.
Lanza un primer clip con tus propios recursos y comprueba si el resultado encaja con tu estándar de marca. Si necesitas consistencia de identidad para campañas, formación o demos, este flujo te permite iterar rápido sin fricción. Empieza con una referencia sencilla y escala a variantes cuando tengas el estilo cerrado.