Langkah 01 — Unggah Potret
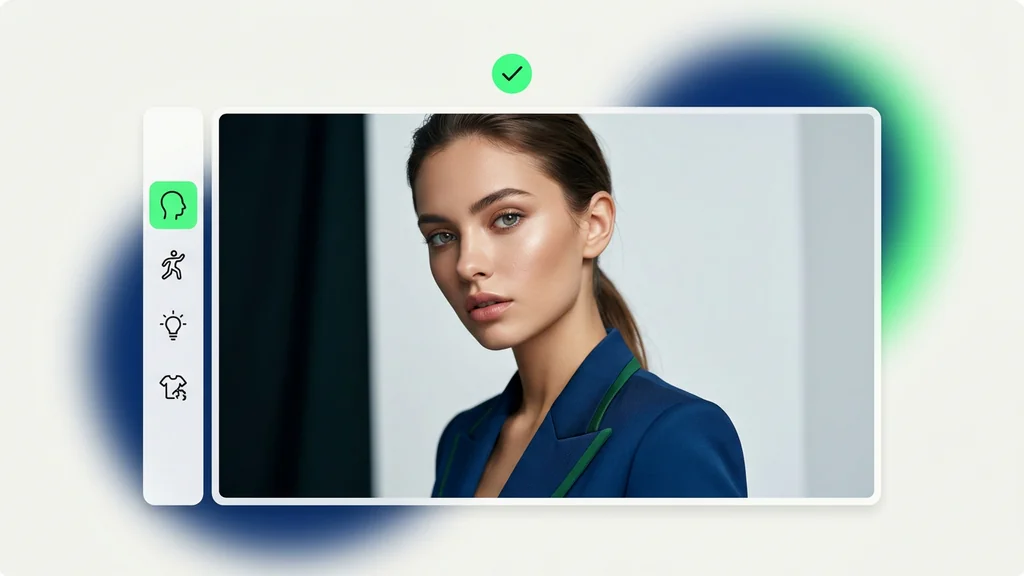
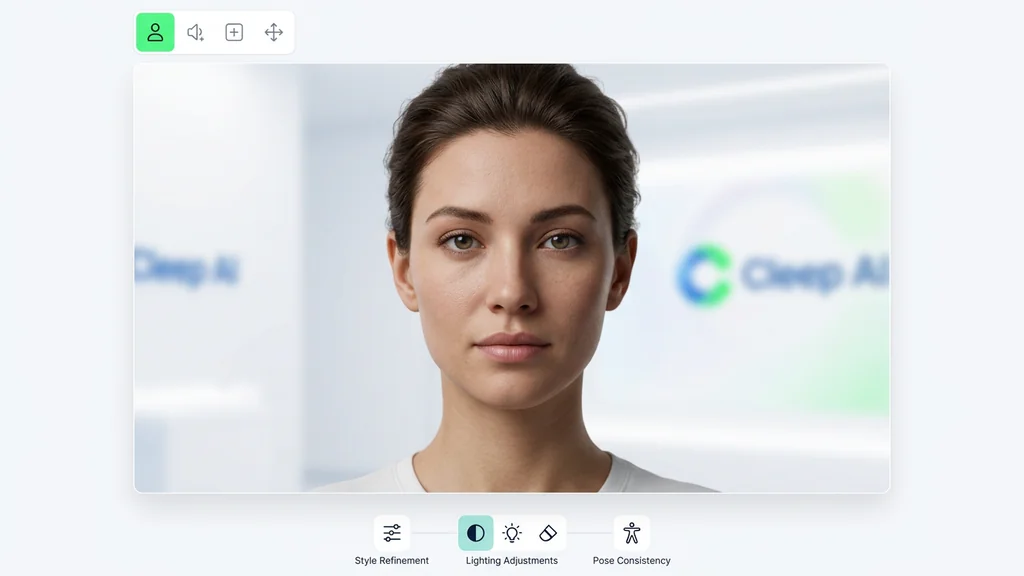
Unggah foto potret yang jelas — inilah wajah yang dihidupkan oleh Omnihuman. Bidikan yang tajam, pencahayaan baik, dan menghadap ke depan memberikan hasil paling alami.
Cleep AI menghadirkan pembuatan video talking dengan lip sync yang presisi, ekspresi wajah stabil, serta gerak tubuh penuh yang realistis dari input foto dan video penggerak. Cocok untuk tim konten yang butuh output cepat, rapi, dan mudah diulang untuk berbagai kampanye.
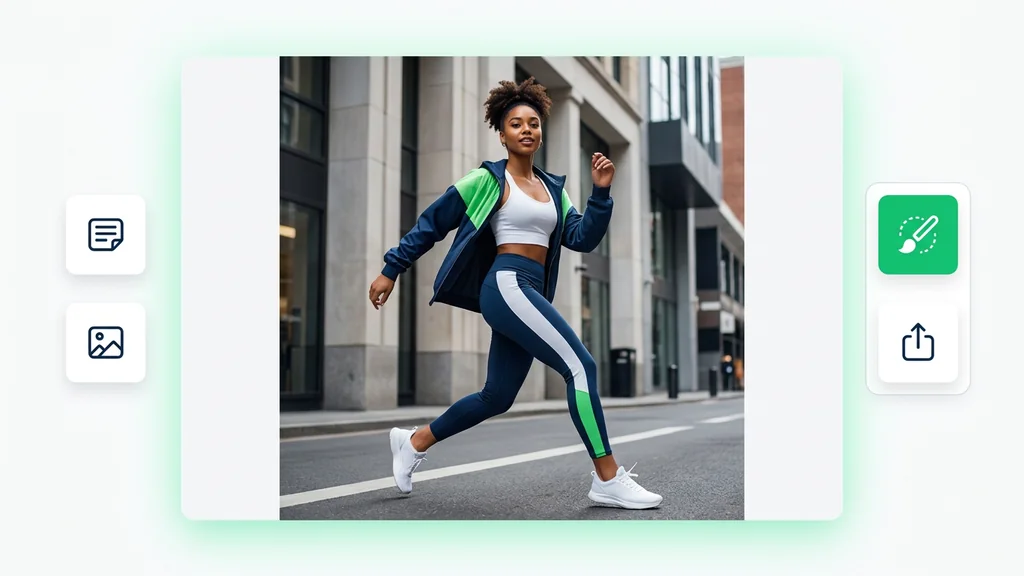
Dari foto atau klip dan trek audio menjadi video berbicara yang tampak hidup — langsung di dalam Cleep.ai.
Unggah foto potret yang jelas — inilah wajah yang dihidupkan oleh Omnihuman. Bidikan yang tajam, pencahayaan baik, dan menghadap ke depan memberikan hasil paling alami.
Unggah trek suara atau musik (hingga 30s). Omnihuman menyinkronkan gerakan bibir dan ekspresi dengan audio Anda untuk penampilan yang alami.
Klik hasilkan dan tunggu beberapa menit. Omnihuman menghasilkan video berbicara Anda dengan audio yang tersinkron. Unduh dan bagikan, atau ganti masukan untuk hasil baru.
Pengguna menyiapkan video penggerak sebagai sumber gestur (video driving), lalu memasangkan foto wajah atau karakter sebagai target. Model memadukan sinyal audio/gerak dalam kerangka Multimodal AI framework agar sinkron antara bibir, mimik, dan ritme tubuh. Dengan Omni-Condition Training Strategy, hasil tetap stabil saat gaya gerak, sudut kamera, atau kondisi pencahayaan berubah.
Tim pemasaran dapat membuat variasi video talking untuk iklan, landing page, dan konten sosial tanpa syuting ulang. Untuk edukasi dan pelatihan, gerak tubuh penuh membantu penyampaian instruksi terasa lebih hidup dibanding hanya wajah. Layanan pelanggan juga bisa memakai avatar untuk menjelaskan prosedur, kebijakan, atau panduan produk dengan konsistensi brand.
Output menargetkan sinkronisasi bibir yang rapat dengan fonem, sehingga dialog terdengar “pas” dengan gerak mulut. Whole-body movement generation menjaga gestur tangan, bahu, dan postur agar tidak kaku saat mengikuti video penggerak. Stabilitas identitas wajah membantu mengurangi perubahan bentuk wajah antar frame sehingga video lebih enak ditonton.
Cleep AI memposisikan alat ini sebagai solusi produksi: dari input sederhana menuju hasil yang siap dipakai untuk kampanye dan materi internal. Pendekatan Multimodal AI framework memudahkan penggabungan sinyal audio, wajah, dan gerak tanpa alur yang rumit. Omni-Condition Training Strategy membantu menjaga konsistensi saat materi sumber bervariasi, sehingga tim bisa mengulang produksi dengan standar yang sama.
Mulai dari satu foto dan satu video penggerak untuk menghasilkan video talking yang rapi untuk kebutuhan bisnis. Uji beberapa variasi gaya gerak dan narasi untuk menemukan format yang paling cocok bagi audiens Indonesia. Saat sudah pas, ulangi prosesnya untuk skala konten yang lebih besar dengan tampilan yang tetap konsisten.