Krok 01 — Prześlij portret
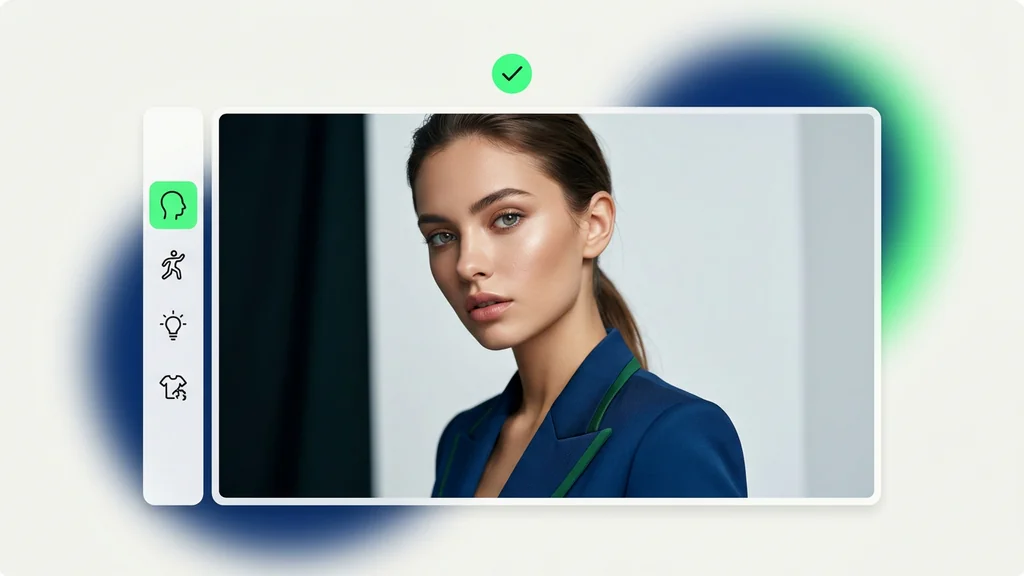
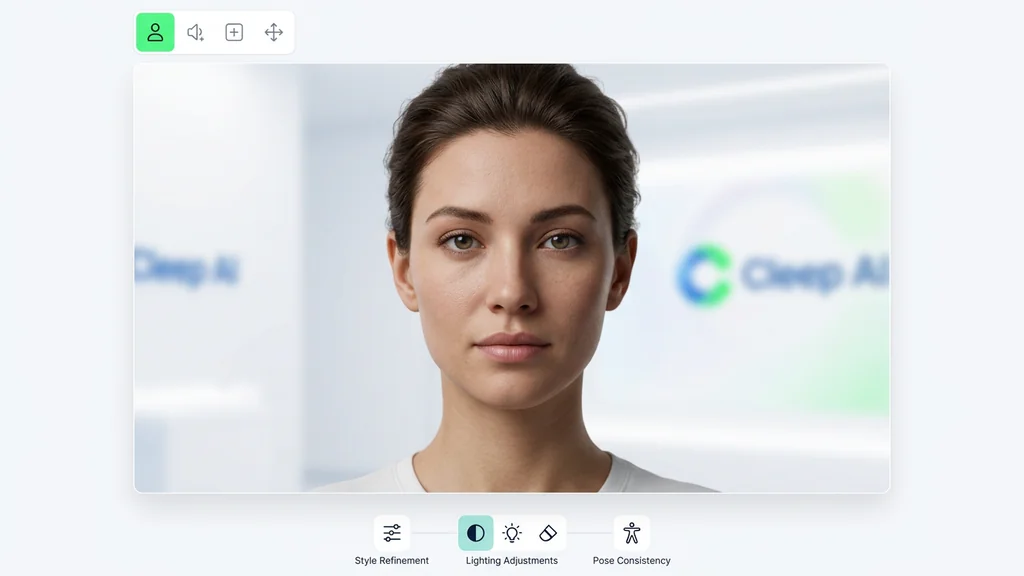
Prześlij wyraźne zdjęcie portretowe — to twarz, którą Omnihuman ożywia. Ostre, dobrze oświetlone ujęcie z przodu daje najbardziej naturalny efekt.
Cleep AI udostępnia model do tworzenia ujęć postaci i scen z naciskiem na filmową grę aktorską, emocje oraz spójność narracji — z gotowym eksportem w popularnych proporcjach obrazu.
Od zdjęcia lub klipu i ścieżki audio do realistycznego mówiącego wideo — bezpośrednio w Cleep.ai.
Prześlij wyraźne zdjęcie portretowe — to twarz, którą Omnihuman ożywia. Ostre, dobrze oświetlone ujęcie z przodu daje najbardziej naturalny efekt.
Prześlij ścieżkę głosu lub muzyki (do 30s). Omnihuman synchronizuje ruch ust i mimikę z Twoim audio, zapewniając naturalny przekaz.
Kliknij generuj i poczekaj kilka minut. Omnihuman tworzy Twoje mówiące wideo ze zsynchronizowanym dźwiękiem. Pobierz je i udostępnij lub zmień materiały wejściowe, aby uzyskać nowe ujęcie.
Proces jest prosty: użytkownik dodaje materiał referencyjny lub obraz, opisuje scenę i emocje, a następnie wybiera proporcje docelowe. Model opiera się na architekturze Diffusion Transformer, co ułatwia utrzymanie spójności ruchu i detali między ujęciami. Dzięki multimodal understanding narzędzie lepiej interpretuje jednocześnie tekst, obraz i kontekst sceny, aby uzyskać naturalniejszą grę aktorską.
Narzędzie sprawdza się w kampaniach, gdzie ten sam przekaz trzeba szybko przygotować pod Reels/TikTok (9:16) i YouTube (16:9) bez utraty czytelności kadru. W produkcjach contentowych wspiera Cinematic Acting & Storytelling: krótkie sceny z wyraźną intencją, tempem i emocjonalnym akcentem. Dla zespołów edukacyjnych ułatwia tworzenie klipów z prowadzącą postacią, gdzie liczy się mimika i wiarygodne emocjonalne aktorstwo.
W ocenie rezultatów kluczowe są: stabilność twarzy, naturalność mimiki oraz ciągłość gestów między klatkami. Model kładzie nacisk na emocjonalne aktorstwo, dlatego warto w opisie sceny podać intencję (np. niepewność, ulga, napięcie) i tempo wypowiedzi/ruchu. Przy materiałach do wielu formatów narzędzie pomaga utrzymać czytelny kadr, aby najważniejsze elementy nie „uciekały” poza bezpieczne pole.
Cleep AI porządkuje pracę: od wejść (tekst/obraz/wideo) po szybkie iteracje i eksport do kanałów, w których liczy się format. Multimodal understanding ułatwia sterowanie sceną bez żmudnego doprecyzowywania każdego detalu, a Diffusion Transformer wzmacnia spójność wizualną w kolejnych wersjach. To podejście jest szczególnie przydatne, gdy priorytetem są filmowe emocje i storytelling, a nie tylko „ruch w kadrze”.
Jeśli zespół potrzebuje jednego źródła do tworzenia scen z postaciami i szybkiego dopasowania do 16:9, 9:16 oraz 1:1, Cleep AI skraca drogę do publikacji. Narzędzie jest nastawione na wiarygodną mimikę, emocjonalne aktorstwo i filmowy rytm scen, co ułatwia budowanie serii i kampanii. Wystarczy dodać materiał, opisać intencję i wybrać format docelowy.