Passo 01 — Descreva sua imagem
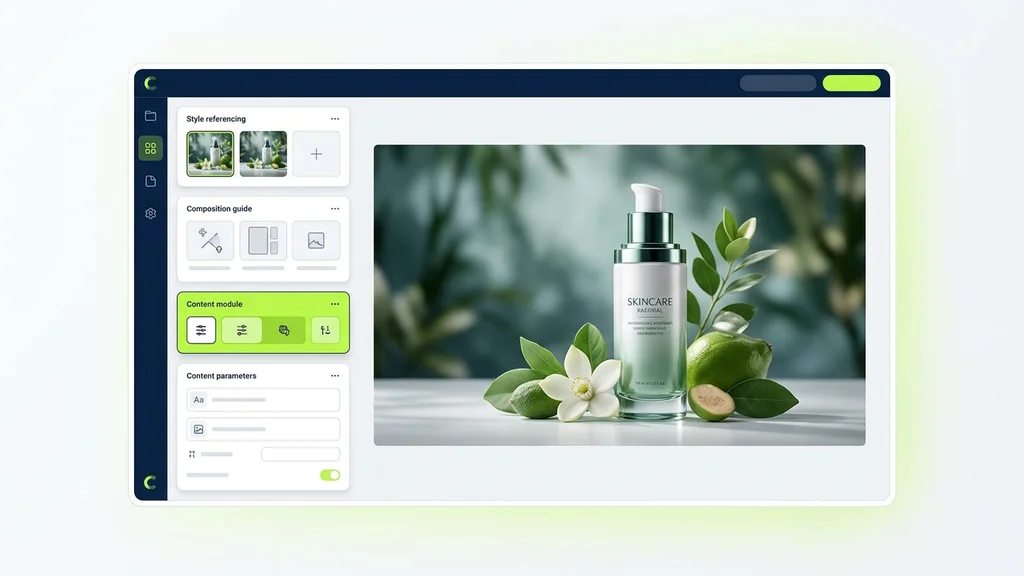
Escreva seu prompt e, se quiser, adicione uma imagem de referência para guiar o estilo, a composição ou o tema.
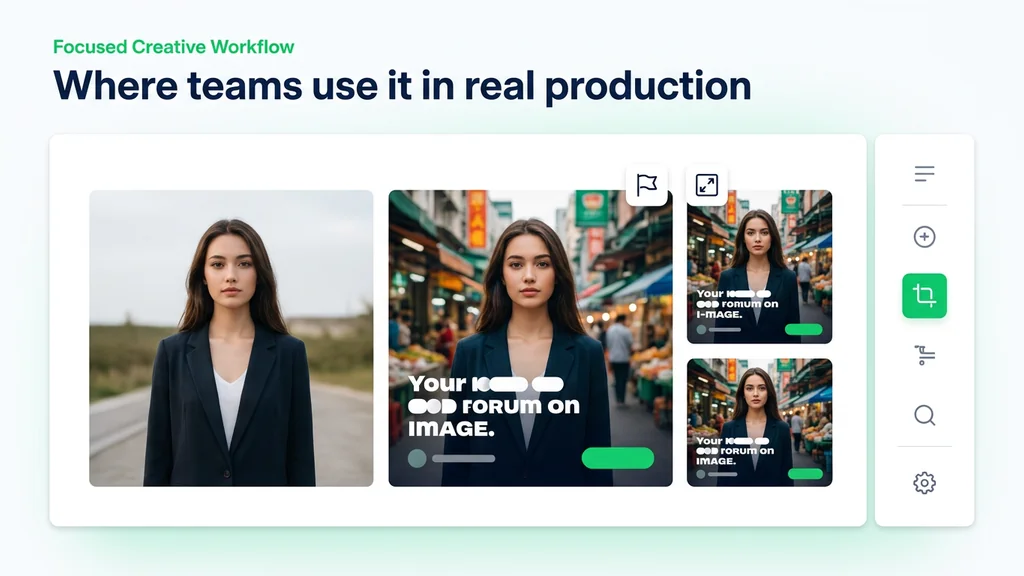
Na Cleep AI, este modelo aplica contexto visual a partir de uma imagem-alvo e, quando necessário, de um rosto de referência para manter identidade, estilo e detalhes consistentes em novas variações e edições.
De uma ideia escrita a uma imagem pronta: sem configuração, sem plugins, sem Discord.
Escreva seu prompt e, se quiser, adicione uma imagem de referência para guiar o estilo, a composição ou o tema.
Selecione uma proporção (9:16, 21:9, 16:9, 4:3) e quantas variações criar de uma vez (até 4). Gere um lote e fique com as que você curtir.
Clique em gerar. O Kontext Max devolve suas imagens em segundos. Baixe as que gostar ou ajuste o prompt e rode de novo.
O usuário envia uma imagem-alvo para definir o contexto visual (composição, paleta e detalhes) e, se precisar preservar identidade, adiciona um rosto de referência. Em seguida, descreve o que deve mudar (ex. : fundo, roupa, iluminação) e executa a geração para obter uma nova versão coerente. Para resultados mais previsíveis, recomenda-se manter a resolução das referências próxima e evitar recortes extremos no rosto.
Times de e-commerce usam o modelo para criar variações de produto mantendo enquadramento e identidade de marca, trocando apenas cenário e luz. Criadores de conteúdo aplicam contexto para manter o mesmo personagem em diferentes cenas sem perder traços principais. Em campanhas, a referência ajuda a padronizar séries de peças (feed, stories e banners) com mudanças controladas.
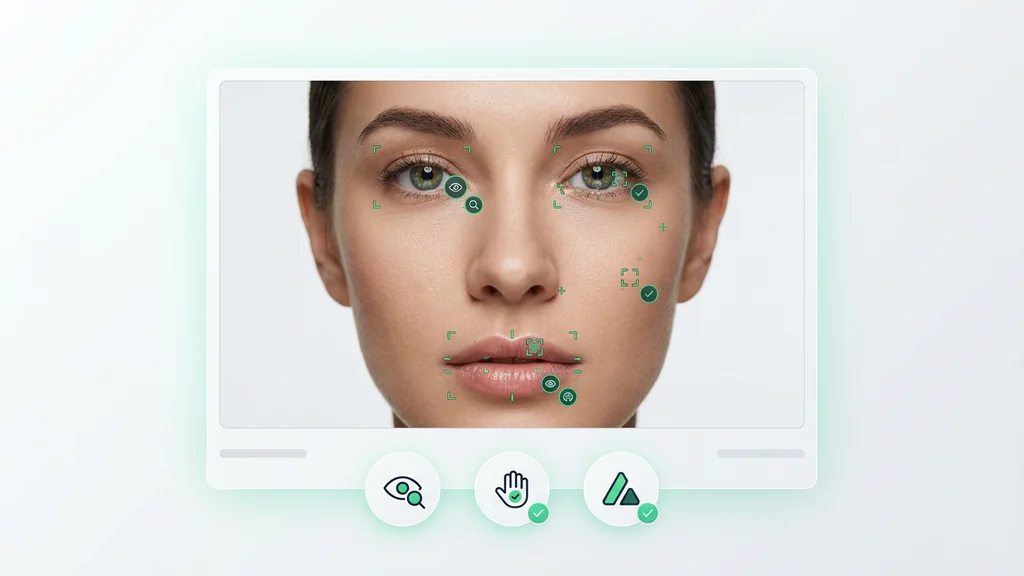
A revisão deve checar fidelidade ao contexto (cores, perspectiva e elementos-chave) e consistência de identidade quando há referência de rosto. Também é importante inspecionar artefatos comuns: mãos, textos em embalagens e bordas com recorte irregular. Para validação rápida, compare a saída com a imagem-alvo em zoom de 100% e confirme se as mudanças solicitadas ocorreram sem alterar o que deveria permanecer.
Em projetos com múltiplas imagens, a recomendação é fixar uma referência-alvo “mestre” e variar apenas um fator por vez para reduzir deriva visual.
Use a Cleep AI para testar o modelo com suas próprias referências e validar consistência antes de colocar a peça em produção. Em poucos envios, dá para comparar variações, escolher a melhor e repetir o padrão em uma série. Quando necessário, refine com uma LoRA e finalize com uma checagem visual rápida.