步骤 01 — 上传人像照片
上传一张清晰的人像照片——这就是 Omnihuman 赋予生命的面孔。画面清晰、光线充足、正面拍摄的照片能带来最自然的效果。
把一段驱动视频变成更自然的人体表演:动作连贯、口型贴合、多人同框更稳定,适合内容团队快速出片与批量迭代。
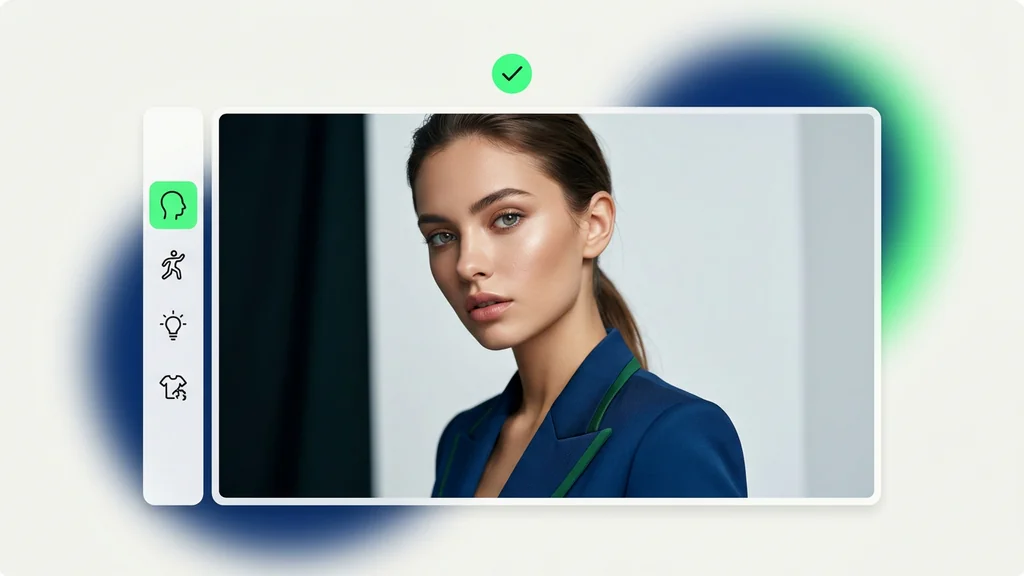
从一张照片或片段加一段音轨,到栩栩如生的说话视频——全程在 Cleep.ai 内完成。
上传一张清晰的人像照片——这就是 Omnihuman 赋予生命的面孔。画面清晰、光线充足、正面拍摄的照片能带来最自然的效果。
上传语音或音乐音轨(最长 30s)。Omnihuman 会将唇部动作和表情与音频同步,呈现自然的表演效果。
点击生成,等待几分钟即可。Omnihuman 会生成音频同步的说话视频。下载后即可分享,或更换输入素材尝试新的效果。
先上传一段包含动作与说话节奏的驱动视频,再提供人物素材作为外观来源。工具会根据视频驱动生成连贯的姿态与表情,并对齐口型与发声节奏。需要多人同框或双人对演时,可分别提供角色素材并统一驱动节奏,减少镜头切换带来的不一致。
用于口播类短视频时,可把现有脚本录音或对白片段与驱动视频结合,快速得到更自然的口型表现。做双人对演时,支持两位角色同框互动,适合对话剧情、带货搭档与访谈式内容。多人同框的团队介绍、课程讲解与活动复盘,也能用统一驱动保持节奏一致。
该方案强调真实口型同步:在快速语速、停顿与重音变化时仍尽量贴合发声节奏。对多人/双人画面,会优先保证同一镜头内的表情与姿态连续,降低「跳帧感」和错位。在复杂动作与遮挡下也更容易保持稳定观感。
在同一工作流里完成上传、生成、预览与导出,适合内容团队高频迭代与批量产出。以视频驱动为核心输入,能复用你已有的拍摄素材与剪辑资产,减少从零制作的成本。对需要双人对演与多人同框的项目,统一驱动与一致性策略更利于稳定交付。
上传一段驱动视频与人物素材,即可快速得到可预览、可下载的成片结果。需要对话类内容时,优先选择清晰的口部画面与稳定光线,效果更容易达到“像真人”的观感。现在就用 Cleep AI 进行一次生成,验证你的场景是否适配。