Passaggio 01 — Descrivi la tua immagine
Scrivi il tuo prompt e, se vuoi, aggiungi un'immagine di riferimento per guidare stile, composizione o soggetto.
Crea e ritocca immagini partendo da testo e da un’immagine di riferimento: mantieni stile, soggetto e dettagli coerenti, poi verifica il risultato prima di esportare o passare all’API.
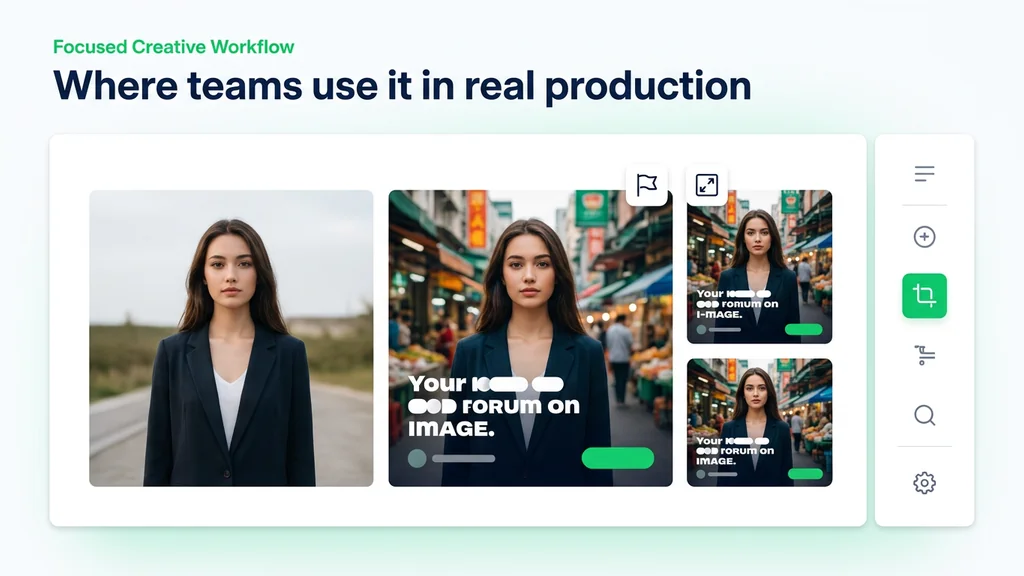
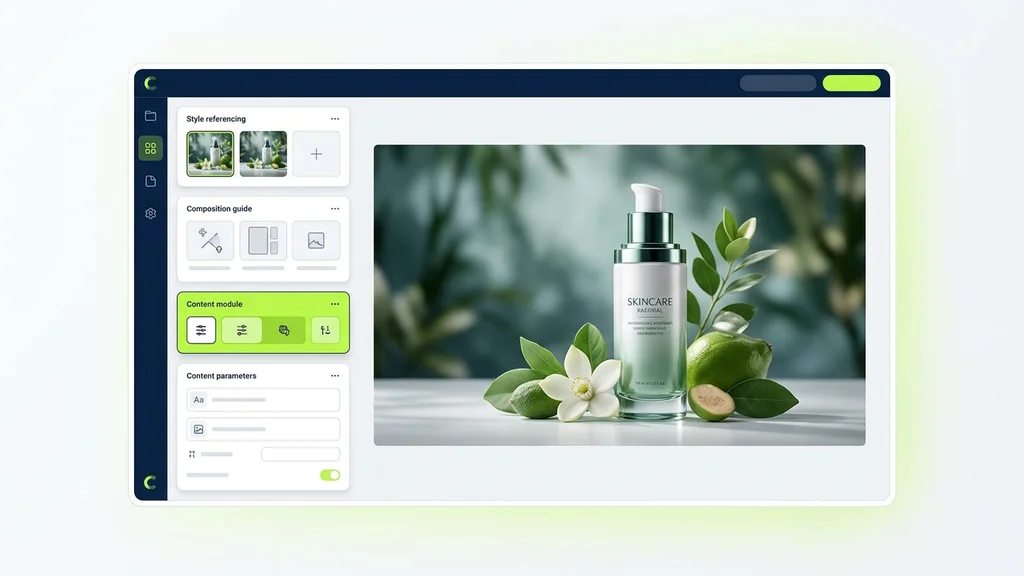
Da un'idea scritta a un'immagine finita: senza configurazione, senza plugin, senza Discord.
Scrivi il tuo prompt e, se vuoi, aggiungi un'immagine di riferimento per guidare stile, composizione o soggetto.
Seleziona un rapporto d'aspetto (9:16, 21:9, 16:9, 4:3) e quante varianti creare in una volta (fino a 4). Genera un gruppo e tieni quelle che preferisci.
Clicca su genera. Kontext Max restituisce le tue immagini in pochi secondi. Scarica quelle che ti piacciono oppure affina il prompt ed esegui di nuovo.
Su Cleep AI si inserisce un prompt e, se serve, si carica un’immagine di base per guidare composizione e inquadratura. Per mantenere identità o stile, si aggiunge un riferimento (ad esempio volto o palette) e si avvia l’elaborazione. Il risultato si rifinisce con iterazioni brevi: si specificano elementi da preservare e cosa cambiare (sfondo, luce, outfit, testo in scena).
Il modello è adatto a creatività per e-commerce e campagne: varianti di prodotto con lo stesso stile, set di immagini per ads e cover coerenti tra loro. Funziona bene anche per editing mirato: sostituzione sfondo, correzione di elementi indesiderati e adattamento del formato per social. Per team che confrontano più text-to-image models, Cleep AI facilita test rapidi e confronto dei risultati su brief identico.
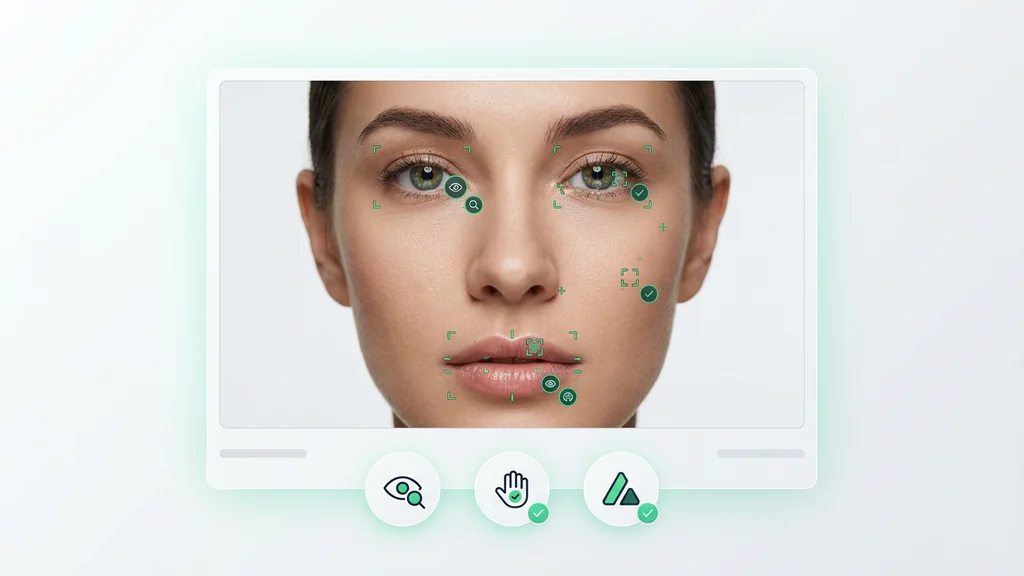
Prima dell’export conviene verificare mani, testo in immagine, loghi e dettagli ripetuti: sono i punti dove le incongruenze emergono più spesso. Per lavori con vincoli di brand, si controllano colori, font “simulati” e proporzioni del prodotto rispetto al riferimento.
Quando il flusso è validato, si può passare dall’uso in interfaccia all’automazione tramite API per produrre varianti su larga scala. In questo modo si confrontano modelli text-to-image e strategie di editing senza cambiare strumenti a ogni step.
Carica un riferimento, descrivi cosa deve restare invariato e cosa va modificato, poi genera una prima versione in pochi minuti. Se il risultato è vicino al target, affina con 1–2 iterazioni e applica la checklist di qualità prima della consegna. Quando la formula funziona, replica lo stesso schema su più creatività o prodotti con un flusso ripetibile.