Trinn 01 — Last opp et portrett
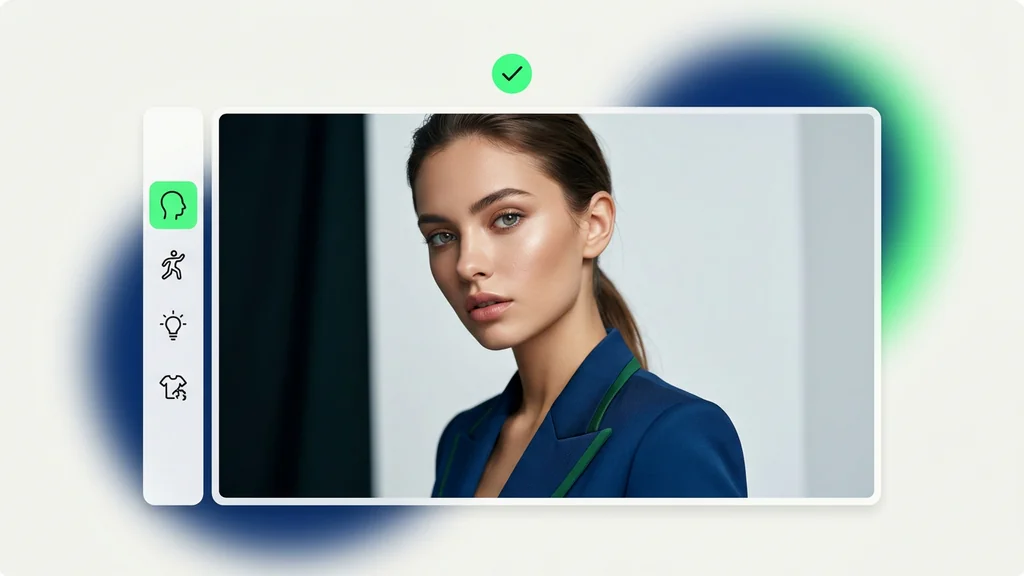
Last opp et tydelig portrettbilde — dette er ansiktet Omnihuman vekker til live. Et skarpt, godt opplyst bilde rett forfra gir det mest naturlige resultatet.
Cleep AI samler en praktisk arbeidsflyt for å skape menneskelig bevegelse i video: fullkroppsbevegelse, stabil tidskonsistens og Lip-Sync som matcher uttrykk og tempo.
Fra et bilde eller klipp og et lydspor til en livaktig snakkende video — rett inne i Cleep.ai.
Last opp et tydelig portrettbilde — dette er ansiktet Omnihuman vekker til live. Et skarpt, godt opplyst bilde rett forfra gir det mest naturlige resultatet.
Last opp stemme- eller musikksporet (opptil 30s). Omnihuman synkroniserer leppebevegelser og uttrykk med lyden din for en naturlig fremføring.
Klikk på generer og vent noen minutter. Omnihuman lager din snakkende video med synkronisert lyd. Last den ned og del, eller bytt ut innholdet for en ny versjon.
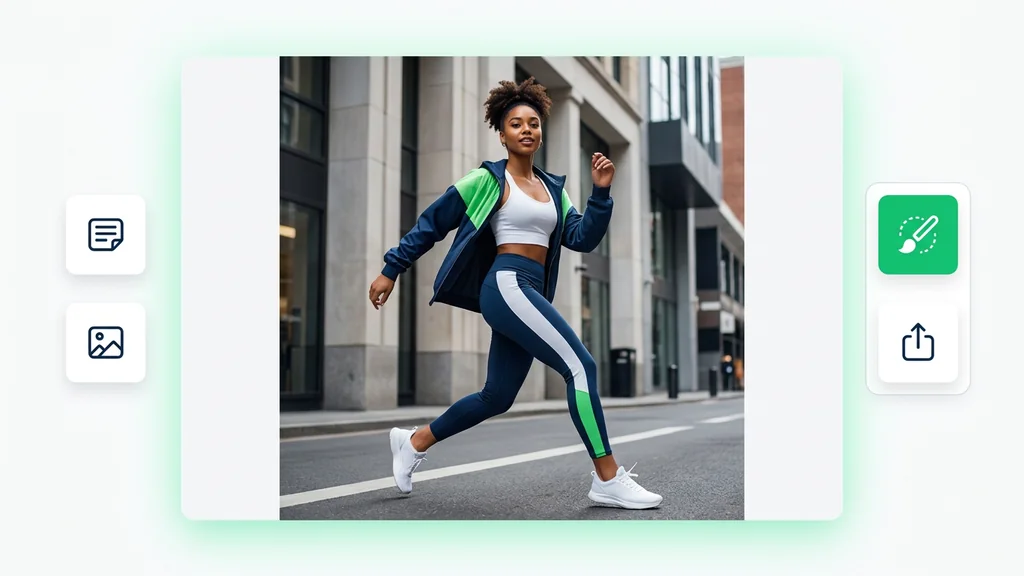
Last opp en bevegelsesreferanse (video eller pose) og velg om du vil legge til et portrett for identitet. Legg til lyd når du trenger Lip-Sync, og kjør for å få en sammenhengende sekvens med fullkroppsbevegelse. Juster lengde og uttrykk ved å iterere på samme oppsett for mer konsistente resultater.
Bruk modellen til produktdemoer, forklaringsvideoer og kampanjer der en digital person må bevege seg troverdig i helfigur. Den passer også til opplæring og internkommunikasjon når du vil gjenbruke samme stil og tempo i flere klipp. For innhold med dialog kan Lip-Sync bidra til at budskapet oppleves mer naturlig uten tung manuell animasjon.
Cleep AI legger opp til en enkel kvalitetssjekk: se etter tidskonsistens, naturlige leddvinkler og stabil identitet gjennom hele sekvensen. Det blir lettere å unngå «hopp» i bevegelsen når klippet blir lengre. Ved dialog vurderes lip-sync mot tydelige konsonanter og pauser, slik at munnbevegelsen følger lyden.
I kjernen ligger en Omni-Condition Training Strategy som gjør at modellen kan ta inn flere signaler samtidig, som bevegelse, identitet og lyd. Det gir bedre generalisering på tvers av scener og reduserer behovet for «triksing» i etterkant. Resultatet er ofte jevnere fullkroppsbevegelse og mer forutsigbar Lip-Sync i samme arbeidsflyt.
Start i Cleep AI og test flyten med din egen referanse for å se hvor raskt du får et brukbart klipp. Gjør en kort runde med kvalitetssjekk, juster og eksporter til kanalene dine. Når du trenger helfigur og dialog i samme leveranse, er dette en effektiv vei fra idé til ferdig video.