步驟 01 — 上傳人像照片
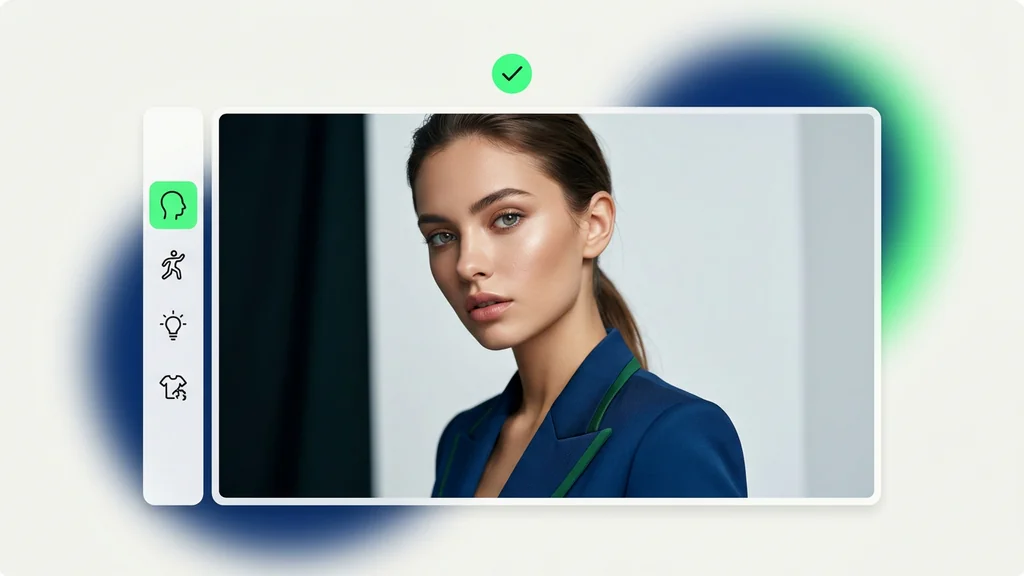
上傳一張清晰的人像照片——這就是 Omnihuman 賦予生命的臉孔。畫面清晰、光線充足、正面拍攝的照片能帶來最自然的效果。
把照片與音訊變成可控的人像影片:全身動作生成、混合條件訓練與多模態 AI 框架一次到位,適合行銷、教學與內容團隊快速交付。
從一張照片或片段加一段音軌,到栩栩如生的說話影片——全程在 Cleep.ai 內完成。
上傳一張清晰的人像照片——這就是 Omnihuman 賦予生命的臉孔。畫面清晰、光線充足、正面拍攝的照片能帶來最自然的效果。
上傳語音或音樂音軌(最長 30s)。Omnihuman 會將唇部動作與表情與音訊同步,呈現自然的演出效果。
點擊生成,等待幾分鐘即可。Omnihuman 會生成音訊同步的說話影片。下載後即可分享,或更換輸入素材嘗試新的效果。
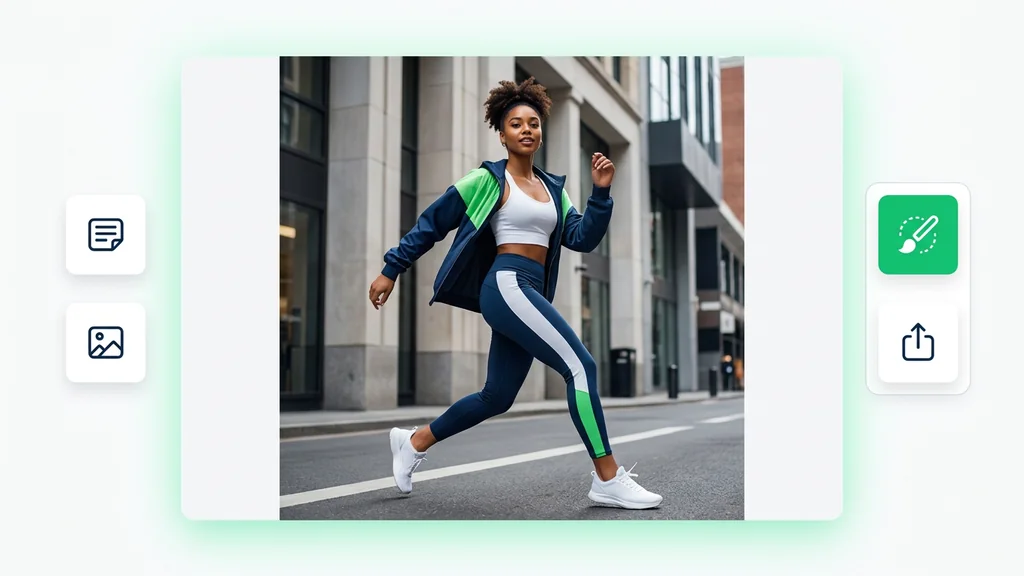
先上傳人物照片或短片,再加入音訊作為驅動來源,並選擇姿態、動作或風格等條件控制。系統以多模態 AI 框架整合影像、音訊與條件訊號,輸出同步的口型、表情與肢體動作。需要更精準時,可用混合條件訓練思路搭配多種約束,讓結果更貼近腳本與分鏡。
用於品牌短影音時,可用音訊驅動讓代言人自然說話,並以全身動作生成補足手勢與站姿,畫面更有說服力。教學與簡報場景可用條件控制固定鏡位與動作節奏,降低重拍成本。客服與公告影片可快速批次產出不同語音版本,維持一致的人物形象與風格。
重點檢查口型與音訊對齊、表情連續性與肢體動作的自然度,避免抖動與突變。若需要更強的指令遵循,可透過混合條件訓練的方式同時加入多種條件訊號,提升穩定性。也建議在上線前做多輪預覽與版本比對,確保品牌一致與合規需求。
在同一套流程中同時處理影像與音訊,並以多模態 AI 框架串起條件控制與輸出管理,減少工具切換。全身動作生成讓畫面不只停留在臉部,能更完整呈現人物表演。搭配可調的條件組合與混合條件訓練策略,讓團隊更容易把結果對齊腳本、分鏡與品牌規範。
現在就用 Cleep AI 進行生成與預覽,快速驗證音訊驅動與全身動作的效果。若你需要更高可控性與一致性,可用條件組合逐步收斂到理想版本。準備好後直接輸出交付,縮短從腳本到上線的時間。